
Dataset de trazas de agentes de IA para evaluación de observabilidad

El proyecto LocalLLaMA/typed-decisions ofrece un conjunto de datos estructurado para el entrenamiento y evaluación de modelos de lenguaje en tareas de observabilidad de agentes de inteligencia artificial. Este recurso, alojado en Hugging Face, contiene trazas de ejecución detalladas que permiten a l
Infino optimiza su motor de búsqueda para almacenar índices en S3

Infino ha diseñado su motor de búsqueda para operar directamente sobre almacenamiento de objetos como S3, GCS y Azure Blob Storage, eliminando la dependencia de discos locales. Esta decisión arquitectónica responde a la necesidad de manejar datos estructurados y no estructurados a gran escala, donde

Netflix optimiza costes de almacenamiento de datos temporales con Cassandra

Netflix ha implementado una estrategia de almacenamiento en capas para su plataforma TimeSeries Abstraction, que gestiona petabytes de datos temporales. El objetivo es reducir los costes de infraestructura manteniendo el rendimiento de baja latencia para datos recientes, mientras se migran los datos

Error de conversión de datos en el visor de Hugging Face

El visor de datos de Hugging Face ha presentado un error de generación que impide la visualización completa del conjunto de datos 'nisten/opus5-5-doctor-patient-conversations-all-human-diseases'. El fallo técnico, identificado como un 'DatasetGenerationError', se debe a una incompatibilidad de tipos

Logfire acelera consultas de datos con 1.000 veces más velocidad

Logfire ha implementado una optimización técnica conocida como 'shredding dinámico' que permite acelerar las consultas de datos hasta 1.000 veces. Esta mejora, que se desplegará para todos los clientes en febrero de 2026, reduce el tiempo de ejecución de consultas que antes tardaban 30 segundos a me

DuckDB 2.0 optimiza consultas con I/O asíncrono y CTE recursivas

DuckDB 2.0, cuya versión alfa ya está disponible, introduce mejoras significativas en el rendimiento para usuarios que construyen pipelines de datos en lugar de motores de bases de datos. El artículo técnico detalla tres características clave que aceleran las consultas sin modificar el código SQL: e

Error técnico impide visualizar el dataset DeskForge-1M en Hugging Face

El dataset DeskForge-1M, alojado en la plataforma Hugging Face, presenta una interrupción técnica que impide la visualización completa de sus datos. La interfaz de usuario muestra únicamente una vista previa limitada debido a un error de generación de datos. El fallo técnico se debe a una excepción

DuckLake: formato de lago de datos integrado con DuckDB

DuckLake es un formato de lago de datos integrado y de catálogo abierto que se construye sobre SQL y Parquet. Este sistema permite almacenar metadatos en una base de datos de catálogo y los datos en archivos Parquet, facilitando la gestión de grandes volúmenes de información mediante un enfoque unif

Parseable: plataforma de observabilidad en Rust con formato Parquet

Parseable es una infraestructura de observabilidad diseñada específicamente para datos de telemetría, escrita en Rust y basada en una arquitectura de lago de datos columnar. Su objetivo principal es gestionar datos de alta cardinalidad con una eficiencia de costes significativamente menor que las so

Implementación técnica del formato Parquet en Haskell

El formato Parquet se ha convertido en el estándar de facto para el almacenamiento de datos en el ecosistema de ciencia de datos, ofreciendo una combinación superior de compresión y eficiencia en la consulta. Para los desarrolladores de Haskell, la capacidad de leer y escribir archivos Parquet es es

QuestDB busca ingeniero pre-venta para Norteamérica

QuestDB, una base de datos de series temporales de baja latencia, ha publicado una oferta de empleo para un ingeniero pre-venta en Norteamérica. El puesto, basado en Nueva York, requiere un perfil técnico que gestione el ciclo de ventas, validando arquitecturas y ejecutando pruebas de concepto para

DuckDB-Wasm permite bases de datos persistentes en el navegador

DuckDB-Wasm ha incorporado soporte para el Origin Private File System (OPFS), permitiendo a las aplicaciones web almacenar bases de datos persistentes directamente en el navegador. Esta funcionalidad, disponible en versiones 1.32.0 y posteriores, resuelve la limitación histórica de la herramienta, q

Paneles de análisis rápidos desde un único archivo Parquet

Este artículo técnico explica cómo crear paneles de análisis interactivos y rápidos a partir de un único archivo Parquet almacenado en un bucket de R2, sin necesidad de una base de datos ni un motor de consultas. El autor, un ingeniero de MotherDuck, presenta el concepto del "cubo de datos" (data cu

Python Polars: hoja de referencia definitiva

Polars es una biblioteca de Python para transformar, analizar y visualizar datos mediante una API de DataFrames rápida y expresiva, publicada por primera vez por Ritchie Vink en 2020. A diferencia de pandas, no emplea un índice de filas y favorece la inmutabilidad y el encadenamiento de métodos; sus

DuckDB incorporará E/S asíncrona en lectura de Parquet y CSV a partir de v2.0

DuckDB prepara su mayor salto arquitectónico en años: a partir de la versión 2.0, prevista para otoño de 2026, el motor de bases de datos analíticas incorporará E/S asíncrona de forma predeterminada para la lectura de archivos Parquet y CSV, una mejora que promete acelerar de forma significativa las

Spotify presenta RAP: índices para consultas puntuales sobre el data lake

Spotify ha detallado en su blog de ingeniería Random Access Parquet (RAP), una técnica para realizar consultas puntuales por clave sobre archivos Parquet almacenados en lagos de datos en la nube, sin necesidad de mantener copias redundantes en sistemas de servicio clave-valor como Bigtable o DynamoD

Cómo paginar un archivo Parquet en DuckDB sin perder filas ni velocidad

Cuando una API tiene que devolver el contenido de un archivo Parquet muy grande y las respuestas están limitadas en tamaño —por ejemplo, 6 MB en AWS Lambda o 32 MiB en Cloud Run—, lo habitual es paginar con LIMIT y OFFSET. Pero esa forma de escribir la consulta es la equivocada. DuckDB ofrece la opc

Hardwood acelera la lectura de listas de longitud fija en Parquet

Hardwood, un lector de Parquet en Java, incorpora una ruta rápida para listas de longitud fija que evita el costoso mecanismo de reconstrucción de registros Dremel cuando todas las listas de una página tienen el mismo tamaño. La técnica detecta, examinando las secuencias de niveles de definición y r

Por qué DuckDB es tan rápida: claves de su diseño interno

DuckDB es una base de datos SQL analítica en proceso que se ha convertido, desde su origen como proyecto de investigación del CWI de Ámsterdam en 2019, en uno de los motores analíticos mononodo más usados y más rápidos del momento. Se distribuye como un binario único de menos de 20 MB, se instala co

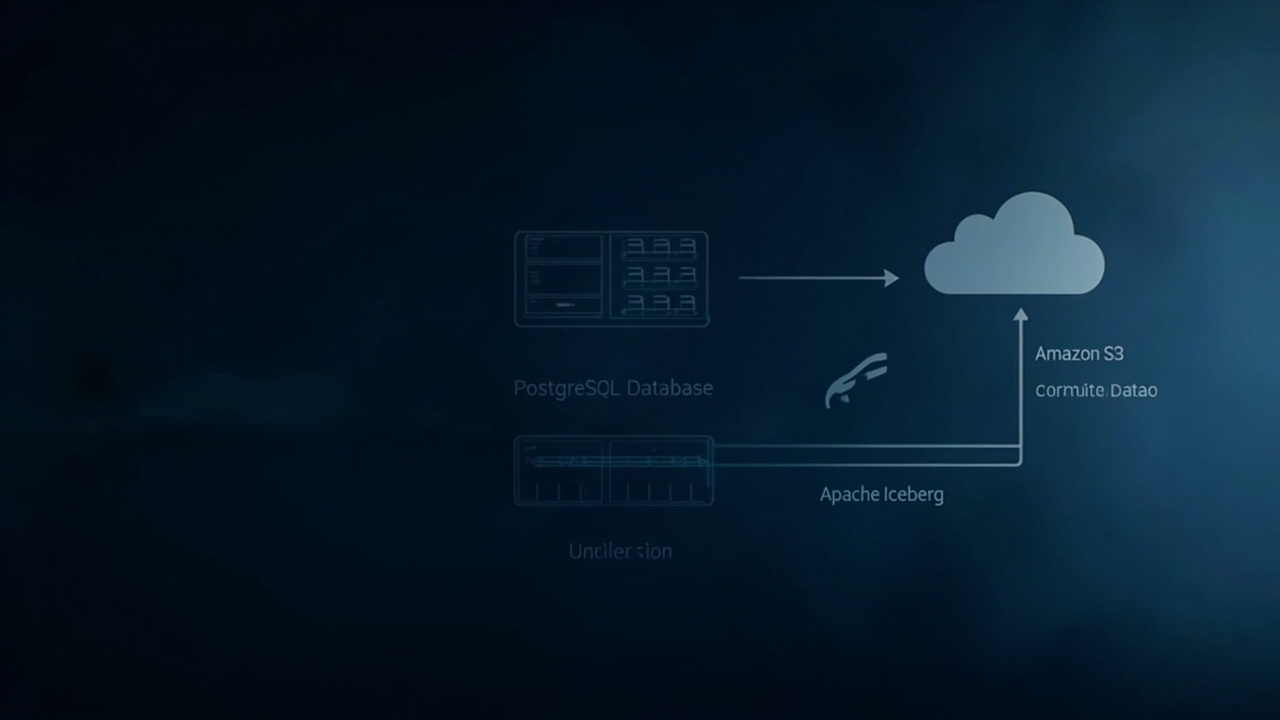
Streambed: motor de CDC de Postgres a Iceberg en S3

Streambed es una herramienta de código abierto que replica cambios de PostgreSQL hacia Apache Iceberg en Amazon S3 mediante replicación lógica, permitiendo consultas analíticas sin modificar la aplicación original. Actúa como suscriptor de replicación lógica: captura los mensajes del WAL (insert, up

KORE Desafía a Parquet con Superior Compresión y Velocidad

KORE es un nuevo formato de archivo binario de alto rendimiento diseñado para cargas de trabajo analíticas, que cuenta con una relación de compresión del 38%—significativamente mejor que el 63% de Parquet—y una aceleración de la consulta de 131x a través de la poda de columnas y el filtrado descende

Hacker News: archivo completo ahora es un conjunto de datos

Hugging Face ha puesto a disposición un extenso conjunto de datos del archivo completo de Hacker News, abarcando desde 2006 hasta marzo de 2026. Este recurso, que incluye cada historia, comentario, pregunta, oferta de trabajo y encuesta publicada en la plataforma, se actualiza cada cinco minutos. Ha

Error en Shopify: Nombre de país causa interrupción de datos

Un error inesperado en el pipeline de datos de Shopify, causado por el nombre oficial del país de Moldavia, ha interrumpido temporalmente la replicación de datos a su sistema de análisis. El problema surgió porque el nombre completo de Moldavia, “Moldova, Republic of”, contenía una coma, que al ser

Vortex: Nueva compresión de datos supera a Parquet

SpiralDB ha anunciado que su sistema de compresión de datos Vortex supera significativamente a Parquet con ZSTD en términos de tamaño y velocidad de descompresión. Vortex utiliza un enfoque inspirado en el trabajo BtrBlocks de la TU Munich, que consiste en probar múltiples codecs de compresión y per

Google Street View: Análisis revela cobertura global

Este artículo describe el proceso de análisis de un conjunto de datos que rastrea la cobertura global de Google Street View a lo largo del tiempo. El autor, Mark Litwintschik, utiliza una potente estación de trabajo (con un procesador AMD Ryzen 9, 96GB de RAM y un SSD NVMe de alta velocidad) y la ba

Lance: Nueva alternativa para Big Data

Un nuevo formato de archivo y tabla llamado Lance ha surgido como una alternativa optimizada a Apache Iceberg y Delta Lake, generando interés en el mundo del big data y el almacenamiento de objetos. Desarrollado en 2025, Lance combina un formato de archivo similar a Parquet (optimizado para lecturas

Overture Lanza Base de Datos Global de 72 Millones de POI

Overture Maps ha publicado un conjunto de datos masivo de 72.4 millones de puntos de interés (POI) que cubre el mundo, como parte de sus lanzamientos mensuales. Estos POI están etiquetados con nombres, categorías y otra información relevante, y el conjunto de datos ha sido mejorado continuamente con